Decision Tree: Introduzione
Parte (1/3)
Potrebbe interessarti:
Il progetto Python, che comprende gli script mostrati in questo post, e quelli relativi alla creazione dei grafici Matplotlib e Plotly, è disponibile assieme al corso Introduzione al Machine Learning.
Cos’è un Decision Tree
Un Decision Tree (albero decisionale) è un algoritmo di apprendimento supervisionato, utilizzato per compiti di classificazione e regressione, che effettua una previsione applicando una sequenza di semplici regole decisionali apprese dalle feature del dataset. Attraverso queste regole, il modello suddivide progressivamente le osservazioni in gruppi sempre più omogenei rispetto alla variabile target, fino ad arrivare a una previsione. Le feature da utilizzare, l’ordine delle decisioni e le relative condizioni vengono determinati automaticamente durante l’addestramento del modello.
Per esempio, consideriamo il gioco da tavolo “Indovina Chi”. Nel gioco, il nostro avversario sceglie un determinato personaggio e noi dobbiamo capire chi è stato scelto ponendo una serie di domande sulle sue caratteristiche, come ad esempio: “porta gli occhiali?”, “ha gli occhi azzurri?”, ecc. Ogni domanda suddivide l’insieme dei personaggi ancora possibili (gli esempi del dataset) in gruppi distinti. Idealmente, scegliamo domande che ci permettano di restringere progressivamente il numero di possibilità. Un Decision Tree segue un principio simile: a ogni passaggio sceglie una feature e una condizione su tale feature per suddividere gli esempi in gruppi che siano il più possibile omogenei rispetto alla variabile target.
Semplificando, un Decision Tree può quindi essere visto come una struttura composta da una serie di condizioni if-then-else, organizzate gerarchicamente, che vengono utilizzate per arrivare a una previsione sulla base delle feature disponibili.
L’Algoritmo di Classificazione
I Decision Tree per la classificazione sono utilizzati per prevedere la classe di appartenenza di un dato esempio. Un Decision Tree è un classificatore strutturato ad albero, nel quale ogni nodo interno rappresenta una regola decisionale applicata a una feature, i rami rappresentano i possibili risultati della decisione, e ogni nodo foglia rappresenta la classe prevista per le osservazioni che raggiungono quel nodo. Vediamo, in forma semplificata, l’algoritmo utilizzato per costruire un albero di classificazione binaria:
Associamo il dataset originale al nodo root (il nodo radice dell’albero):
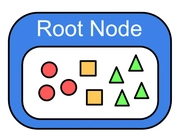
Figura 1: Nodo Root Partendo dal nodo root, cerchiamo una regola decisionale basata su una feature e su un valore di soglia (ad esempio: “feature $\le$ valore” oppure “feature $\gt$ valore”) che permetta di suddividere gli esempi del nodo in due sottoinsiemi il più possibile omogenei rispetto alla classe di appartenenza. L’obiettivo è quindi trovare una suddivisione (split) che riduca il più possibile l’impurità: una misura di quanto le diverse classi risultano mescolate all’interno dei nodi generati. Un nodo ha impurità minima quando contiene esclusivamente esempi appartenenti alla stessa classe; al contrario, l’impurità aumenta quando gli esempi delle diverse classi sono maggiormente mescolati.
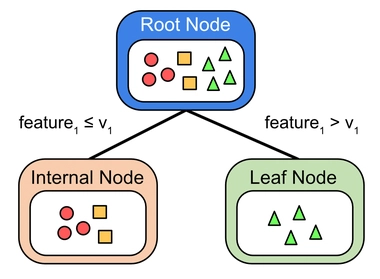
Figura 2: Prima Suddivisione Associamo i due sottoinsiemi appena creati a un nuovo nodo figlio sinistro e a un nuovo nodo figlio destro. Per ciascun nodo figlio ripetiamo ricorsivamente lo stesso processo di partizionamento, cercando una nuova regola decisionale che permetta di ridurre ulteriormente l’impurità. Man mano che si scende nella struttura dell’albero, ogni suddivisione genera sottoinsiemi che contengono generalmente un numero sempre minore di esempi e che tendono a essere sempre più omogenei rispetto alla classe di appartenenza:
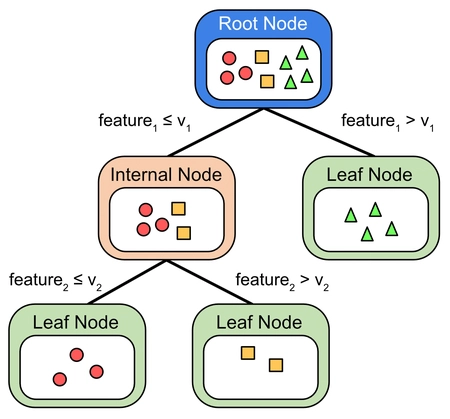
Figura 3: Seconda Suddivisione Quando il processo di divisione genera un nodo puro, contenente esclusivamente esempi della stessa classe, oppure quando viene soddisfatta una determinata condizione di arresto (ad esempio, è stata raggiunta la profondità massima consentita per l’albero, oppure il numero di esempi disponibili è insufficiente per effettuare un’ulteriore suddivisione), interrompiamo la ricorsione per quel ramo e generiamo un nodo foglia. Al nodo foglia viene associata una classe prevista. Se il nodo non è puro, questa corrisponde generalmente alla classe più frequente tra gli esempi che hanno raggiunto il nodo:
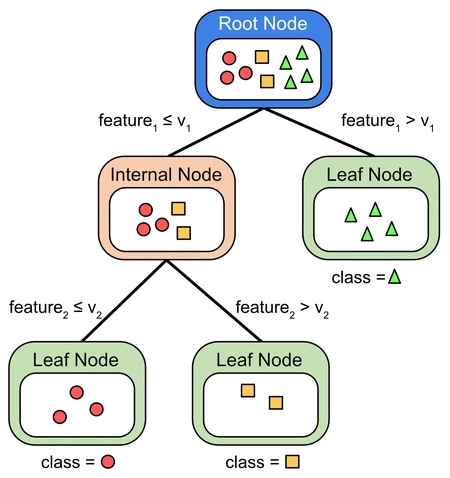
Figura 4: Obiettivo di Classificazione


La Funzione di Ipotesi del Decision Tree
Ogni percorso che va dal nodo root a un nodo foglia rappresenta una specifica sequenza di regole decisionali
utilizzata per prevedere la label di classe di un dato esempio.
L’insieme di tutti questi percorsi rappresenta la funzione di ipotesi del classificatore:
una struttura di condizioni annidate che guida il processo decisionale
in base ai valori delle feature e alle soglie apprese durante l’addestramento.
Queste condizioni possono essere rappresentate come una serie di istruzioni if-then-else, ad esempio:
if feature_1 <= v_1:
    if feature_2 <= v_2:
        return "circle"
    else:
        return "rectangle"
else:
    return "triangle"
Per questo motivo, i Decision Tree sono generalmente facili da interpretare:
la struttura dell’albero può essere tradotta direttamente in un insieme di regole decisionali
if-then-else facilmente comprensibili.
Modello Non-Parametrico e Greedy
Un Decision Tree è un modello non parametrico: non assume a priori una particolare forma funzionale per descrivere la relazione tra le feature di input e la variabile target.
Ad esempio, la Regressione Lineare assume che la relazione tra le feature di input $x_i$ e il valore previsto $\hat{y}$ possa essere rappresentata attraverso una funzione lineare nei parametri:
$$ \hat{y} = w_1x_1 + w_2x_2 + \dots + w_nx_n + b $$La forma del modello è quindi stabilita a priori e l’addestramento consiste nel determinare i valori dei parametri $w_1,\dots,w_n$ e $b$.
Un Decision Tree, invece, non impone una forma funzionale predefinita alla relazione tra feature e target. La struttura e la complessità dell’albero vengono determinate durante l’addestramento, scegliendo le feature, i valori di soglia e le regole decisionali utilizzate per suddividere i dati. Per questo motivo, il numero di parametri necessari a descrivere un Decision Tree non è fissato a priori, ma dipende dalla struttura dell’albero appresa dai dati.
Un Decision Tree utilizza inoltre una strategia di apprendimento greedy (“avida”). Durante la costruzione dell’albero, a ogni nodo viene effettuata un’ottimizzazione locale: tra le suddivisioni considerate, viene scelta quella che produce il miglior risultato secondo il criterio utilizzato, ad esempio la maggiore riduzione dell’impurità. Una volta scelta una suddivisione, l’algoritmo procede ricorsivamente sui nodi figli, senza tornare indietro per verificare se una scelta diversa avrebbe potuto produrre, nel complesso, un albero migliore.
L’algoritmo non esplora quindi tutti i possibili alberi generati dalle diverse combinazioni e sequenze di suddivisioni. Di conseguenza, la strategia greedy non garantisce di trovare l’albero globalmente ottimale. Il vantaggio è però computazionale: cercare esaustivamente il miglior albero possibile sarebbe estremamente costoso. La strategia greedy permette invece di ottenere, in un tempo ragionevole, una buona soluzione attraverso una sequenza di scelte localmente ottimali.
Un Esempio Pratico
Per capire meglio come viene costruito un Decision Tree per la classificazione, consideriamo questo dataset composto da $7$ esempi, descritti da $3$ feature (“Loves Popcorn”, “Loves Soda”, “Age”) e dalla label target binaria “Loves Pop Music”:
| id | f: Loves Popcorn | f: Loves Soda | f: Age | l: Loves Pop Music |
|---|---|---|---|---|
| 1 | Yes | Yes | 7 | No |
| 2 | Yes | No | 12 | No |
| 3 | No | Yes | 18 | Yes |
| 4 | No | Yes | 35 | Yes |
| 5 | Yes | Yes | 38 | Yes |
| 6 | Yes | No | 50 | No |
| 7 | No | No | 83 | No |
Partiamo dal nodo root del nostro ipotetico albero e dividiamo il dataset originale utilizzando la regola decisionale che produce il maggiore Information Gain (IG).
L’Entropia è una misura dell’impurità di un insieme di esempi rispetto alla loro classe: è minima quando tutti gli esempi appartengono alla stessa classe e aumenta quando le diverse classi risultano maggiormente mescolate. L’Information Gain misura invece quanto una determinata suddivisione riduce l’Entropia. Confronta quindi l’impurità del nodo padre con l’impurità complessiva dei nodi figli generati dallo split. Maggiore è l’Information Gain, maggiore è la riduzione dell’impurità ottenuta dalla suddivisione. In altre parole, l’Information Gain permette di valutare quanto bene una determinata regola decisionale separi gli esempi del dataset in base alla loro classe di appartenenza.
Per ora facciamo “un atto di fede” e assumiamo che la regola decisionale che produce il maggiore Information Gain sia basata sulla feature “Loves Soda” (i calcoli saranno illustrati successivamente). Ciò significa che, tra le suddivisioni considerate per il nodo root, quella basata su “Loves Soda” produce la migliore separazione delle classi secondo il criterio dell’Information Gain. Pertanto, il dataset originale viene diviso in due sottoinsiemi:
poiché la feature “Loves Soda” è binaria, possiamo utilizzare come regola decisionale:
"Loves Soda == Yes"(equivalentemente, potremmo utilizzare"Loves Soda == No");la regola viene utilizzata per dividere il dataset originale in due subset: un subset contenente gli esempi per i quali “Loves Soda” = “Yes”, associato a un nodo figlio, e un subset contenente gli esempi per i quali “Loves Soda” = “No”, associato all’altro nodo figlio. La struttura risultante è la seguente:
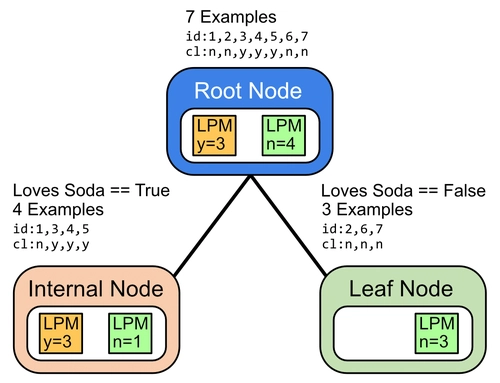
Figura 5: Loves Soda Il primo subset contiene $4$ esempi che “amano la soda”: $3$ appartengono alla classe positiva, “Loves Pop Music” = “Yes”, mentre uno appartiene alla classe negativa, “Loves Pop Music” = “No”. Questo nodo è quindi ancora impuro. Il secondo subset contiene invece $3$ esempi che non “amano la soda”, tutti appartenenti alla classe negativa, “Loves Pop Music” = “No”. Poiché tutti gli esempi appartengono alla stessa classe, questo è un nodo puro e può diventare un nodo foglia.
Ripetiamo ricorsivamente la procedura di suddivisione per ogni nodo ancora impuro, fino a quando viene raggiunto un nodo puro oppure viene soddisfatta una determinata condizione di arresto, come la profondità massima consentita per l’albero o un numero insufficiente di esempi per effettuare un’ulteriore suddivisione.
Consideriamo ora il subset impuro generato dalla precedente suddivisione su “Loves Soda”.
Assumiamo che, tra le possibili suddivisioni di questo nodo,
la regola decisionale con il maggiore Information Gain sia "Age <= 15".
Applichiamo quindi questa nuova regola al subset e otteniamo un’ulteriore suddivisione:

In questo caso, i due nodi risultanti sono entrambi puri: il primo contiene solamente l’esempio con “Age” $\le 15$, appartenente alla classe “No”, mentre il secondo contiene i tre esempi con “Age” $\gt 15$, tutti appartenenti alla classe “Yes”. Possiamo quindi interrompere il processo di suddivisione per entrambi i rami. Per completare la struttura dell’albero, a ogni nodo foglia associamo una classe prevista. In generale, se il nodo non è puro, la classe prevista corrisponde alla classe più frequente tra gli esempi che hanno raggiunto quel nodo:

Quando utilizziamo una regola decisionale per suddividere gli esempi associati a un nodo, memorizziamo nel nodo le informazioni necessarie a rappresentare tale regola, come la feature utilizzata e, quando necessario, il relativo valore di soglia. Una volta addestrato l’albero, effettuare una previsione su un esempio mai visto prima è semplice. L’esempio viene fatto passare attraverso l’albero partendo dal nodo root. A ogni nodo interno viene valutata la relativa regola decisionale e, in base al risultato, l’esempio viene indirizzato verso uno dei due nodi figli. Il processo continua fino al raggiungimento di un nodo foglia. La classe associata a tale nodo rappresenta la predizione del modello. L’insieme e l’ordine di queste regole decisionali definiscono quindi la funzione di ipotesi appresa dal modello.
Nel nostro esempio, essa può essere rappresentata attraverso la seguente struttura if-then-else:
if loves_soda:
    if age <= 15:
        return "Class 0"  # Does Not Love Pop Music
    else:
        return "Class 1"  # Loves Pop Music
else:
    return "Class 0"      # Does Not Love Pop Music
Massimizzazione dell’Information Gain
L’Entropia è una misura dell’incertezza associata alla distribuzione delle classi all’interno di un dataset o, più precisamente nel nostro caso, degli esempi associati a un nodo. Maggiore è l’Entropia, più uniformemente gli esempi sono distribuiti tra le diverse classi e, di conseguenza, maggiore è l’incertezza sulla classe di appartenenza di un’osservazione. Quando invece tutti gli esempi appartengono alla stessa classe, il nodo è puro e la sua Entropia è uguale a zero. Dal punto di vista della teoria dell’informazione, l’Entropia può essere misurata in bit e rappresenta la quantità media di informazione necessaria per descrivere l’esito di una variabile casuale, quando viene utilizzato il logaritmo in base $2$.
Con incertezza indichiamo quanto è difficile prevedere la classe di un’osservazione, sapendo soltanto che essa si trova in quel nodo. Supponiamo che un nodo di un Decision Tree contenga $100$ osservazioni. Se abbiamo:
$$ C_0=99,\qquad C_1=1 $$quando arriva un’osservazione in quel nodo, possiamo prevedere $C_0$ con grande sicurezza: il $99\%$ degli esempi del nodo appartiene a $C_0$. L’incertezza è bassa. Se invece abbiamo:
$$ C_0=50,\qquad C_1=50 $$sapere che l’osservazione si trova in quel nodo non ci aiuta molto a stabilire a quale classe appartenga: entrambe hanno probabilità stimata del 50%. L’incertezza è massima. l’Entropia misura quanto è incerta la classe di un’osservazione scelta dal nodo, considerando la distribuzione delle classi presenti nel nodo.
L’Information Gain (IG) misura la riduzione dell’Entropia ottenuta attraverso una determinata suddivisione (split). Confronta quindi l’Entropia del nodo padre con l’Entropia complessiva dei nodi figli, pesata in base al numero di esempi presenti in ciascun nodo. In altre parole, l’Information Gain misura quanto una determinata suddivisione riesca a separare gli esempi del dataset di addestramento rispetto alle loro classi target. Maggiore è la purezza dei nodi figli rispetto al nodo padre, maggiore è la riduzione dell’Entropia e quindi maggiore è l’Information Gain.
Negli alberi decisionali, a ogni nodo cerchiamo quindi lo split che massimizza la riduzione dell’impurità. Possiamo esprimere questo criterio attraverso la seguente funzione obiettivo1:
$$ \begin{align} \text{IG}(D_p, s) = I(D_p) - \sum_{j=1}^{m} \left(\frac{N_j}{N_p} I(D_j)\right) \end{align} $$dove:
- $D_p$ è il dataset associato al nodo padre;
- $s$ è lo split considerato, definito ad esempio da una feature e da un valore di soglia;
- $D_j$ è il dataset associato al $j$-esimo nodo figlio;
- $N_j$ è il numero di esempi di training associati al $j$-esimo nodo figlio;
- $N_p$ è il numero di esempi di training associati al nodo padre;
- $\frac{N_j}{N_p}$ è il peso associato al $j$-esimo nodo figlio;
- $I$ è la misura di impurità utilizzata per valutare i nodi.
Pertanto, il criterio confronta l’impurità del nodo padre con la media pesata delle impurità dei nodi figli. Più bassa è l’impurità pesata dei nodi figli, maggiore è la riduzione dell’impurità prodotta dallo split.
I Decision Tree implementati dalle principali librerie di Machine Learning, tra cui Scikit-Learn, utilizzano normalmente split binari: ogni nodo interno viene quindi suddiviso in due nodi figli, $D_{\text{left}}$ e $D_{\text{right}}$. In questo caso, la riduzione dell’impurità viene calcolata come:
$$ \begin{align} \text{IG}(D_p, s) &= I(D_p) - \left(\frac{N_\text{left}}{N_p} I(D_{\text{left}}) + \frac{N_\text{right}}{N_p} I(D_{\text{right}})\right)\\[6pt] &= I(D_p) - \frac{N_\text{left}}{N_p} I(D_{\text{left}}) - \frac{N_\text{right}}{N_p} I(D_{\text{right}}) \end{align} $$Durante l’addestramento, vengono considerate diverse possibili suddivisioni e viene scelta quella che produce la maggiore riduzione dell’impurità. Vediamo ora nel dettaglio due delle principali misure utilizzate per valutare l’impurità dei nodi: Entropy e Gini Impurity.
Entropy
Entropy (Entropia) misura l’incertezza media associata ai possibili messaggi prodotti da una fonte. Essa può essere interpretata come la quantità media di informazione che otteniamo ogni volta che osserviamo un messaggio proveniente da quella fonte. Un messaggio poco probabile è più “sorprendente” e fornisce una maggiore quantità di informazione; al contrario, un messaggio molto probabile è meno sorprendente e fornisce meno informazione. L’Entropia è definita dalla seguente formula:
$$ \begin{align} H(X) = -\sum_{i=1}^{I} p(x_i)\log_2\left(p(x_i)\right) \end{align} $$dove:
- $X$ è la variabile casuale che rappresenta i messaggi prodotti dalla fonte;
- $I$ è il numero di possibili messaggi distinti;
- $x_i$ è l’$i$-esimo possibile messaggio;
- $p(x_i)$ è la probabilità che si verifichi il messaggio $x_i$.
In particolare, la quantità:
$$ -\log_2\left(p(x_i)\right) $$misura l’informazione, o sorpresa, associata all’osservazione del messaggio $x_i$, espressa in bit. Più bassa è la probabilità $p(x_i)$, maggiore è la sorpresa associata alla sua osservazione:

L’Entropia $H(X)$ calcola quindi la sorpresa media, pesando la sorpresa di ogni possibile messaggio per la relativa probabilità di verificarsi.
Relativamente a un classificatore Decision Tree, l’Entropia viene utilizzata come misura dell’impurità di un nodo rispetto alla distribuzione delle classi ed è definita come:
$$ \begin{align} I_{H}\left(t\right) & = -\sum_{c=1}^{C} p\left(c|t\right)\log_2\left(p\left(c|t\right)\right)\\[6pt] \end{align} $$dove:
- $I_H(t)$ è l’Entropia del nodo $t$ dell’albero decisionale e misura il livello di impurità della distribuzione delle classi al suo interno;
- $C$ è il numero delle classi considerate;
- $p(c|t)$ è la proporzione degli esempi appartenenti alla classe $c$ tra tutti gli esempi presenti nel nodo $t$.
I termini relativi alle classi con $p(c|t)=0$ vengono considerati uguali a zero, secondo la convenzione:
$$ 0\log_2(0)=0 $$Abbiamo detto che l’Entropia è $0$ quando tutti gli esempi presenti in un nodo appartengono alla stessa classe. Se, ad esempio, tutti gli esempi appartengono alla Classe “$1$”, abbiamo $p(c=1|t)=1$ e quindi:
$$ \begin{align} I_H(t) & = -p(1|t)\log_2\left(p(1|t)\right)\\[6pt] & = -1\log_2(1)\\[6pt] & = -1 \cdot 0\\[6pt] & = 0 \text{ bit} \end{align} $$In questo caso non abbiamo alcuna incertezza sulla classe: sapendo che un’osservazione appartiene al nodo, sappiamo che appartiene alla Classe “$1$”.
Al contrario, a parità di numero di classi, l’Entropia è massima quando gli esempi sono distribuiti uniformemente tra le classi. Ad esempio, in un problema di classificazione binaria, se $p(c=1|t)=p(c=0|t)=0.5$, abbiamo:
$$ \begin{align} I_{H}\left(t\right) & = -p\left(1|t\right)\log_2\left(p\left(1|t\right)\right) + \\[6pt] & ~~~ -p\left(0|t\right)\log_2\left(p\left(0|t\right)\right)\\[6pt] & = -0.5\log_2(0.5) + \\[6pt] & ~~~ -0.5\log_2(0.5)\\[6pt] & = 0.5 + 0.5\\[6pt] & = 1 \text{ bit} \end{align} $$In questo caso, conoscendo soltanto il nodo in cui si trova un’osservazione, abbiamo la massima incertezza sulla sua classe di appartenenza: metà degli esempi appartiene alla Classe “$0$” e metà alla Classe “$1$”.

Con una distribuzione uniforme di $10$ classi, per la quale $p(c|t)=0.1$ per ogni classe $c$, abbiamo invece:
$$ \begin{align} I_H(t) & = -\sum_{c=1}^{10} p(c|t)\log_2\left(p(c|t)\right)\\[6pt] & = -0.1\log_2(0.1) \times 10\\[6pt] & \approx 3.32 \text{ bit} \end{align} $$In generale, con $C$ classi distribuite uniformemente, l’Entropia raggiunge il valore massimo:
$$ I_H^{\max}=\log_2(C) $$Gini Impurity
Gini Impurity (Impurità di Gini) misura la probabilità che un esempio scelto casualmente da un dataset venga classificato in modo errato, se gli viene assegnata casualmente una classe secondo la distribuzione delle classi presenti nel dataset stesso. Relativamente a un classificatore Decision Tree, l’Impurità di Gini viene utilizzata per misurare quanto un nodo sia “puro” o “impuro”. Per un nodo $t$ con $C$ classi, l’Impurità di Gini è definita come:
$$ \begin{align} I_G(t) &= \sum_{c=1}^{C} p(c|t)\left[1-p(c|t)\right]\\[6pt] &= p(1|t)-p(1|t)^2 + p(2|t)-p(2|t)^2 + \cdots + p(C|t)-p(C|t)^2\\[6pt] &= 1-\sum_{c=1}^{C}p(c|t)^2 \end{align} $$dove:
- $I_G(t)$ è l’Impurità di Gini del nodo $t$ dell’albero decisionale e misura il livello di impurità della distribuzione delle classi al suo interno;
- $C$ è il numero totale delle classi;
- $p(c|t)$ è la proporzione degli esempi appartenenti alla classe $c$ tra tutti gli esempi presenti nel nodo $t$;
- $p(1|t)+\cdots+p(C|t)=1$.
La formula $1-\sum_c p(c|t)^2$ può essere interpretata in modo intuitivo. Immaginiamo di effettuare due estrazioni indipendenti dalla distribuzione delle classi del nodo. Possiamo pensare alla prima estrazione come alla classe reale di un’osservazione, e alla seconda come alla classe assegnata casualmente secondo la stessa distribuzione. La probabilità che entrambe le estrazioni restituiscano la classe $c$ è:
$$ p(c|t) \cdot p(c|t) = p(c|t)^2 $$Potremmo quindi ottenere due volte la classe $c_1$, con probabilità $p(c_1|t)^2$, due volte la classe $c_2$, con probabilità $p(c_2|t)^2$, e così via. Poiché questi eventi sono reciprocamente esclusivi, la probabilità complessiva che le due classi coincidano è:
$$ \sum_{c=1}^{C}p(c|t)^2 = p(1|t)^2 + p(2|t)^2 + \dots + p(C|t)^2 $$Di conseguenza, per la regola del complemento, la probabilità che le due classi siano diverse è:
$$ 1 - \sum_{c=1}^{C} p(c|t)^2 $$Questa quantità corrisponde alla probabilità di classificare erroneamente un’osservazione se la sua classe viene assegnata casualmente secondo la distribuzione delle classi presenti nel nodo.
Analogamente all’Entropy, Gini Impurity è pari a $0$ quando tutti gli esempi di un nodo appartengono alla stessa classe. Se, ad esempio, il nodo è completamente puro, e tutti gli esempi appartengono alla Classe “$1$”, $p(c=1|t)=1$, abbiamo:
$$ \begin{align} I_G(t) &= 1-p(c=1|t)^2\\[6pt] &= 1-1^2\\[6pt] &= 0 \end{align} $$Al contrario, a parità di numero di classi, Gini Impurity è massima quando gli esempi sono distribuiti uniformemente tra le classi. In un problema di classificazione binaria, il valore massimo è quindi $0.5$. Se $p(c=1|t)=p(c=0|t)=0.5$, abbiamo:
$$ \begin{align} I_G(t) &= 1-\left[p(1|t)^2+p(0|t)^2\right]\\[6pt] &= 1-0.5^2-0.5^2\\[6pt] &= 0.5 \end{align} $$Più in generale, con $C$ classi distribuite uniformemente, $p(c|t)=1/C$, e Gini Impurity raggiunge il valore massimo:
$$ I_G^{\max}=1-\frac{1}{C} $$Relativamente a un problema di classificazione binaria, il grafico seguente mostra il valore dell’Impurità di Gini in funzione della proporzione di esempi appartenenti alla Classe Positiva, $p(c=1)$:

Si noti come Gini Impurity sia massima quando $p(c=1)=0.5$, ovvero quando gli esempi presenti nel nodo sono equamente distribuiti tra la Classe Positiva e la Classe Negativa. Il valore diminuisce invece man mano che una delle due classi diventa predominante, fino a raggiungere $0$ quando il nodo contiene esclusivamente esempi appartenenti a una sola classe.
Considerando il dataset “Love Pop Music”, i valori Gini Impurity calcolati per ogni feature sono mostrati di seguito.
“Loves Popcorn”
La feature booleana “Loves Popcorn” suddivide il dataset di partenza in questo modo:

Nel subset di sinistra abbiamo 4 osservazioni, dove 1 è associata alla label positiva, e 3 a quella negativa. In quello di destra abbiamo 3 osservazioni, dove 2 sono associate alla label positiva, e 1 a quella negativa. Il valore di Gini Impurity totale associato all’espressione “Loves Popcorn == True” (oppure Loves Popcorn == False) è calcolato in questo modo:
$$ \begin{align} I_{G}\left(t\right) & = 1 - p(c=1|t)^2 - p(c=0|t)^2\\[6pt] I_{G}\left(D_\text{left}\right) & = 1 - \left(\frac{1}{4}\right)^2 - \left(\frac{3}{4}\right)^2 && \text{// 4 esempi: 1 yes; 3 no}\\[6pt] & = 1 - \frac{1}{16} - \frac{9}{16} = \frac{6}{16}\\[6pt] & = 0.375\\[6pt] I_{G}\left(D_\text{right}\right) & = 1 - \left(\frac{2}{3}\right)^2 - \left(\frac{1}{3}\right)^2 && \text{// 3 esempi: 2 yes; 1 no}\\[6pt] & = 1 - \frac{4}{9} - \frac{1}{9} = \frac{4}{9}\\[6pt] & = 0.444\\[6pt] I_{G_\text{total}}(D_\text{left}, D_\text{right}) & = \frac{N_\text{left}}{N_p} \cdot I_{G}\left(D_\text{left}\right) + \frac{N_\text{right}}{N_p} \cdot I_{G}\left(D_\text{right}\right)\\[6pt] & = \frac{4}{7} \cdot 0.375 + \frac{3}{7} \cdot 0.444\\[6pt] & = 0.405\\[6pt] \end{align} $$dove $I_{G_\text{total}}(D_\text{left}, D_\text{right})$ è la somma pesata di $I_{G}\left(D_\text{left}\right)$ e $I_{G}\left(D_\text{right}\right)$, considerando un totale di $7$ esempi.
“Loves Soda”
La feature booleana “Loves Soda” suddivide il dataset di partenza in questo modo:

Nel subset di sinistra abbiamo 4 osservazioni, dove 3 sono associate alla label positiva, e 1 a quella negativa. In quello di destra abbiamo 3 osservazioni, tutte associate alla label negativa (questo identifica un dataset puro). Il valore di Gini Impurity totale associato all’espressione “Loves Soda == True” (oppure “Loves Soda == False”) è calcolato in questo modo:
$$ \begin{align} I_{G}\left(D_\text{left}\right) & = 1 - \left(\frac{3}{4}\right)^2 - \left(\frac{1}{4}\right)^2 && \text{// 4 esempi: 1 yes; 3 no}\\[6pt] & = 0.375\\[6pt] I_{G}\left(D_\text{right}\right) & = 1 - \left(\frac{0}{3}\right)^2 - \left(\frac{3}{3}\right)^2 && \text{// 3 esempi: 0 yes; 3 no}\\[6pt] & = 0\\[6pt] I_{G_\text{total}}(D_\text{left}, D_\text{right}) & = \frac{4}{7} \cdot 0.375 + \frac{3}{7} \cdot 0 = 0.214\\[6pt] \end{align} $$“Age”
Poiché la feature “Age” contiene valori numerici, Il calcolo di Gini Impurity è un po’ più complesso del calcolo delle feature booleane. In questo caso, dobbiamo:
ordinare i valori “Age” in ordine crescente:
$7, 12, 18, 35, 38, 50, 83$per ogni coppia di valori “Age” $(\text{Age}i, \text{Age}{i+1})$:
calcolare il valore mediano correlato:
- $\text{median}(07, 12) = 9.5$
- $\text{median}(12, 18) = 15$
- $\text{median}(18, 35) = 26.5$
- $\text{median}(35, 38) = 36.5$
- $\text{median}(38, 50) = 44$
- $\text{median}(50, 83) = 66.5$
usare ogni valore mediano calcolato al punto 2.1 per dividere il dataset in due nodi, e calcolare il valore Gini Impurity totale:
- $\text{Age Median}$ $09.5$ $\rightarrow$ $I_{G_\text{total}} = 0.429$
- $\text{Age Median}$ $15.0$ $\rightarrow$ $I_{G_\text{total}} = 0.343$ (valore più basso)
- $\text{Age Median}$ $26.5$ $\rightarrow$ $I_{G_\text{total}} = 0.476$
- $\text{Age Median}$ $36.5$ $\rightarrow$ $I_{G_\text{total}} = 0.476$
- $\text{Age Median}$ $44.0$ $\rightarrow$ $I_{G_\text{total}} = 0.343$ (valore più basso)
- $\text{Age Median}$ $66.5$ $\rightarrow$ $I_{G_\text{total}} = 0.429$
selezionare il valore mediano di “Age” associato al valore più basso di Gini Impurity totale. In questo caso, il valore di Gini più basso è $0,343$, associato a due valori mediani di età: $15$ e $44$. Selezioniamo $15$ (oppure $44$). Pertanto, la regola decisionale utilizzata per suddividere il dataset diventa “Age $\gt$ 15” (oppure “Age $\le$ 15”), e il valore Gini Impurity totale associato è $0,343$.
Riassumendo, le regole decisionali del dataset, ordinate in ordine crescente in base al valore Gini Impurity totale, sono:
- “Loves Soda == True” $(0.214)$
- “Age $\le$ 15” $(0.343)$
- “Loves Popcorn == True” $(0.405)$
Di seguito possiamo vedere il codice usato per calcolare i valori $I_{G}\left(D_\text{left}\right)$, $I_{G}\left(D_\text{right}\right)$ e $I_{G_\text{total}}$ di cui sopra:
def _total_gini_impurity(X, y, dec_rule_left, dec_rule_right):
    """Calculate the Total Gini Impurity of a group of observations based on the ratio of examples
       (probabilities) belonging to class 0 and class 1."""
    # Dataset left
    # =========================================
    D_left_ids = np.argwhere(dec_rule_left).ravel()
    p_c0, p_c1 = _proba(y[D_left_ids])
    Ig_left = _gini_impurity(p_c0, p_c1)

    # Dataset right
    # =========================================
    D_right_ids = np.argwhere(dec_rule_right).ravel()
    p_c0, p_c1 = _proba(y[D_right_ids])
    Ig_right = _gini_impurity(p_c0, p_c1)

    # Total Gini Impurity
    # =========================================
    m = len(X)
    w_left = len(D_left_ids) / m
    w_right = len(D_right_ids) / m
    Ig_total = w_left * Ig_left + w_right * Ig_right
    return Ig_total, Ig_left, Ig_right

def _proba(y):
    """Calculate the ratio of examples (probabilities) belonging to class 0 and class 1."""
    m = len(y)
    p_c0 = np.count_nonzero(y == 0) / m
    p_c1 = np.count_nonzero(y == 1) / m
    return p_c0, p_c1

def _gini_impurity(p_c0, p_c1):
    """Calculate the Gini Impurity of a group of boolean observations based on the ratio of examples
       (probabilities) belonging to class 0 and class 1."""
    # I_G(t) = 1 - ∑(c=1,C) { p(c|t)^2 }
    return 1 - p_c0**2 - p_c1**2

def total_gini_impurity_bool(X, y):
    """Calculate the Total Gini Impurity of a group of boolean observations
       based on the ratio of examples (probabilities) belonging to class 0 and class 1."""
    return _total_gini_impurity(X, y, X == 1, X == 0)

def total_gini_impurity_float(X, y):
    # sort unique values in ascending order. Then, for each pair of age values (age_i, age_i+1),
    # compute the related median value. Then use that value to split the dataset into two nodes,
    # to compute the Total Gini Impurity
    X_u = np.unique(X)
    values = []
    for i in range(len(X_u) - 1):
        median = np.median((X_u[i], X_u[i + 1]))
        Ig_total, _, _ = _total_gini_impurity(X, y, X <= median, X > median)
        values.append((median, Ig_total))
    return values

def print_gini_impurity(X, y, feature_idx, feature_label):
    Ig_total, Ig_left, Ig_right = total_gini_impurity_bool(X[:, feature_idx], y)
    print(f"Total Gini Impurity for '{feature_label}': {Ig_total:.3f} "
          f"(left: {Ig_left:.3f}, right: {Ig_right:.3f})")

# "Loves Pop Music" Dataset.
# Features are: "Loves Popcorn", "Loves Soda", "Age"
X = np.array([[True,  True,  7],
              [True,  False, 12],
              [False, True,  18],
              [False, True,  35],
              [True,  True,  38],
              [True,  False, 50],
              [False, False, 83]])

# "Loves Pop Music" Label
y = np.array([0, 0, 1, 1, 1, 0, 0])

print_gini_impurity(X, y, 0, "Loves Popcorn")
print_gini_impurity(X, y, 1, "Loves Soda")

values = total_gini_impurity_float(X[:, 2], y)
print("Total Gini Impurity values for 'Age' Median:")
for value in values:
    print(f"  'Age' Median: {value[0]} -> Ig_total: {value[1]:.3f}")

print("\nBest Total Gini Impurity value, and associated 'Age' Median:")
id = np.argmin(np.array(values)[:, 1])
value = values[id]
print(f"  Ig_total: {value[1]:.3f} -> 'Age' Median: {value[0]}")
Una funzione obiettivo è una funzione matematica che rappresenta il criterio che vogliamo ottimizzare, cioè massimizzare o minimizzare, all’interno di un problema. È generalmente espressa come $f(\mathbf{x})$, dove $\mathbf{x}$ rappresenta l’insieme delle variabili decisionali rispetto alle quali viene effettuata l’ottimizzazione. ↩︎